
Hyper-V in GitHub Actions: pro Job eine frische Azure-VM
Mein VM-Tool Sailwright lässt sich nur testen, wenn die automatische Build- und Testumgebung (CI) selbst wieder virtuelle Maschinen startet. Die Standard-Runner von GitHub Actions unterstützen das offiziell nicht. Deshalb startet eine kleine Azure Function für jeden Testlauf eine frische Windows-VM und löscht sie danach wieder. Im Leerlauf kostet diese Lösung rund 2,50 € im Monat, dazu kommen rund 14 Cent pro Build.
Kurzfassung
Ich entwickle Sailwright, ein Tool, das echte Windows-, Linux- und macOS-VMs baut und testet. Die Windows-Builds entstehen mit Hyper-V, dem in Windows eingebauten Hypervisor von Microsoft. Um sie automatisch zu prüfen, muss in der CI eine VM innerhalb einer VM starten (Nested Virtualization). Die GitHub-hosted Runner, also die Maschinen, auf denen CI-Jobs standardmäßig laufen, unterstützen das offiziell nicht.
Ein Self-hosted Runner ist ein Runner auf eigener Infrastruktur. Läuft er als Windows-VM rund um die Uhr, kostet er auch dann Geld, wenn nichts gebaut wird. Die hier genutzte VM-Größe Standard_D4ds_v5 hat 4 vCPUs und 16 GB RAM. Als reguläre Windows-VM kostet sie in der Azure-Region East US 2 rund 260 € im Monat. Als vergünstigte Spot-VM sind es zum aktuellen Preis rund 110 €. Die Disk kommt jeweils noch dazu.
Deshalb startet eine kleine Azure Function für jeden CI-Job eine eigene Windows-VM mit Hyper-V. Eine Azure Function ist Code, den Azure nur bei Aufruf ausführt und abrechnet. Diese Function nenne ich den „Broker“. Er nutzt Spot-VMs, also stark vergünstigte VMs, die Azure bei Bedarf zurückholen kann. Die VM übernimmt genau einen Job, danach löscht der Broker sie samt Festplatte, Netzwerk und IP-Adresse.
GitHub stellt jedem Workflow-Lauf ein kurzlebiges, signiertes Token aus (GitHub OIDC). Ich habe Azure so eingerichtet, dass es diesen Tokens aus meinem Repository vertraut. Im Repository liegen deshalb keine gespeicherten Zugangsdaten für Azure.
Im Leerlauf kostet die Plattform rund 2,50 € im Monat. Fast alles davon entfällt auf Speicher, etwa auf das vorbereitete VM-Image (Golden Image), aus dem jede Runner-VM startet. Dazu kommen rund 14 Cent pro Build.
Der Artikel zeigt:
- warum ein VM-Tool in der CI Nested Virtualization braucht
- wie Broker und Runner-VMs zusammenspielen und wie sich das Golden Image selbst aktuell hält
- wo es knifflig wurde: Hyper-V auf einer Cloud-VM aktivieren
- das Sicherheitskonzept und was beim Hardening noch offen ist
- wie die Rechnung zustande kommt und welche Fehler sie aufgedeckt hat
Ein VM-Tool testen heißt: Die CI braucht einen Hypervisor
Sailwright kombiniert Ansible mit Tools, die VMs bauen und einrichten. So lassen sich dieselben Playbooks gegen echte macOS-, Linux- und Windows-Ziele testen, bevor sie auf dem Rechner eines Entwicklers landen. Technisch ist Sailwright eine Go-CLI. Sie steuert Packer, Vagrant sowie Hyper-V, QEMU oder VirtualBox, um kurzlebige Test-VMs zu bauen und einzurichten.
Genau das macht die CI Pipeline komplex: Wer ein Tool testen will, das VMs baut, braucht einen CI-Runner, der selbst einen Hypervisor betreibt. Die beiden Tests, die über ein Windows-Release entscheiden, starten tatsächlich eine Nested VM, also eine VM innerhalb der Runner-VM:
TestBuildHypervWindows11Amd64OnWindows– ein vollständiger Hyper-V-Build von Windows 11 mit Packer.TestRunHypervVagrantDeployOnWindows_Smoke– rollt die erzeugte.boxmit Vagrant auf Hyper-V aus.
Das Packer-Template dafür installiert Windows 11 in einer Hyper-V-VM. Aus dem Ergebnis macht das Template anschließend eine Vagrant-Box. Den „Default Switch“ legt das Setup-Skript des Runners an (siehe unten).
# build/packer/windows/windows11-on-windows-hyperv.pkr.hcl (gekürzt)
source "hyperv-iso" "win11" {
  # ...
  switch_name        = "Default Switch"
  # ...
  enable_secure_boot = true
  generation         = 2
  enable_tpm         = true
  # ...
}
Quelle: windows11-on-windows-hyperv.pkr.hcl:58
Laut GitHub ist Nested Virtualization auf den GitHub-hosted Runnern zwar technisch möglich, aber offiziell nicht unterstützt und ausdrücklich experimentell (GitHub-Doku). Für eine verlässliche CI reicht das nicht. Ich brauche also einen Self-hosted Runner auf einer VM-Größe, die Nested Virtualization unterstützt. Bei Azure ist das zum Beispiel die Dds_v5-Familie, ich nutze Standard_D4ds_v5. Azure passt hier gut: Diese VMs gibt es als günstige Spot-VMs, und die Anmeldung aus GitHub kommt ohne gespeicherte Azure-Secrets aus.
Es gibt fertige Lösungen für Runner, die pro Job starten und danach wieder verschwinden. Gepasst hat aber keine davon. Canonicals Provisioner arbeitet auf Azure nach demselben Muster, ist aber archiviert. Das Terraform-Modul terraform-aws-github-runner setzt auf AWS.
Als ich im Dezember 2025 angefangen habe, lief Hyper-V in einer AWS-VM nur auf teuren Bare-Metal-Instanzen. Normale Instanzen kamen erst im Februar 2026 dazu (AWS-Ankündigung). Billiger wäre AWS auch heute nicht. In AWS‘ eigener Spot-Preisliste kostet Windows bei vergleichbaren Größen (m6i und m7i, us-east-1, Oktober 2026) rund 0,18 $ pro Stunde mehr als Linux. Der Lizenzaufschlag fällt bei Spot also in voller Höhe an. Für eine m8i.xlarge schätze ich den Windows-Spot-Preis damit auf rund 0,28 $ (etwa 0,25 €) pro Stunde. Die Azure-VM kostet als Spot-VM rund 0,15 € pro Stunde. Pro Build wären das gut 20 statt rund 14 Cent.
Vor allem wollte ich einer fremden Lösung keine weitreichenden Rechte in meiner Cloud-Umgebung geben. Mit dem eigenen Broker behalte ich die volle Kontrolle und kann die Workarounds einbauen, die eine saubere Automatisierung braucht, etwa beim Hyper-V-Setup weiter unten.
Pro Job eine frische VM: Broker, Runner und Ablauf
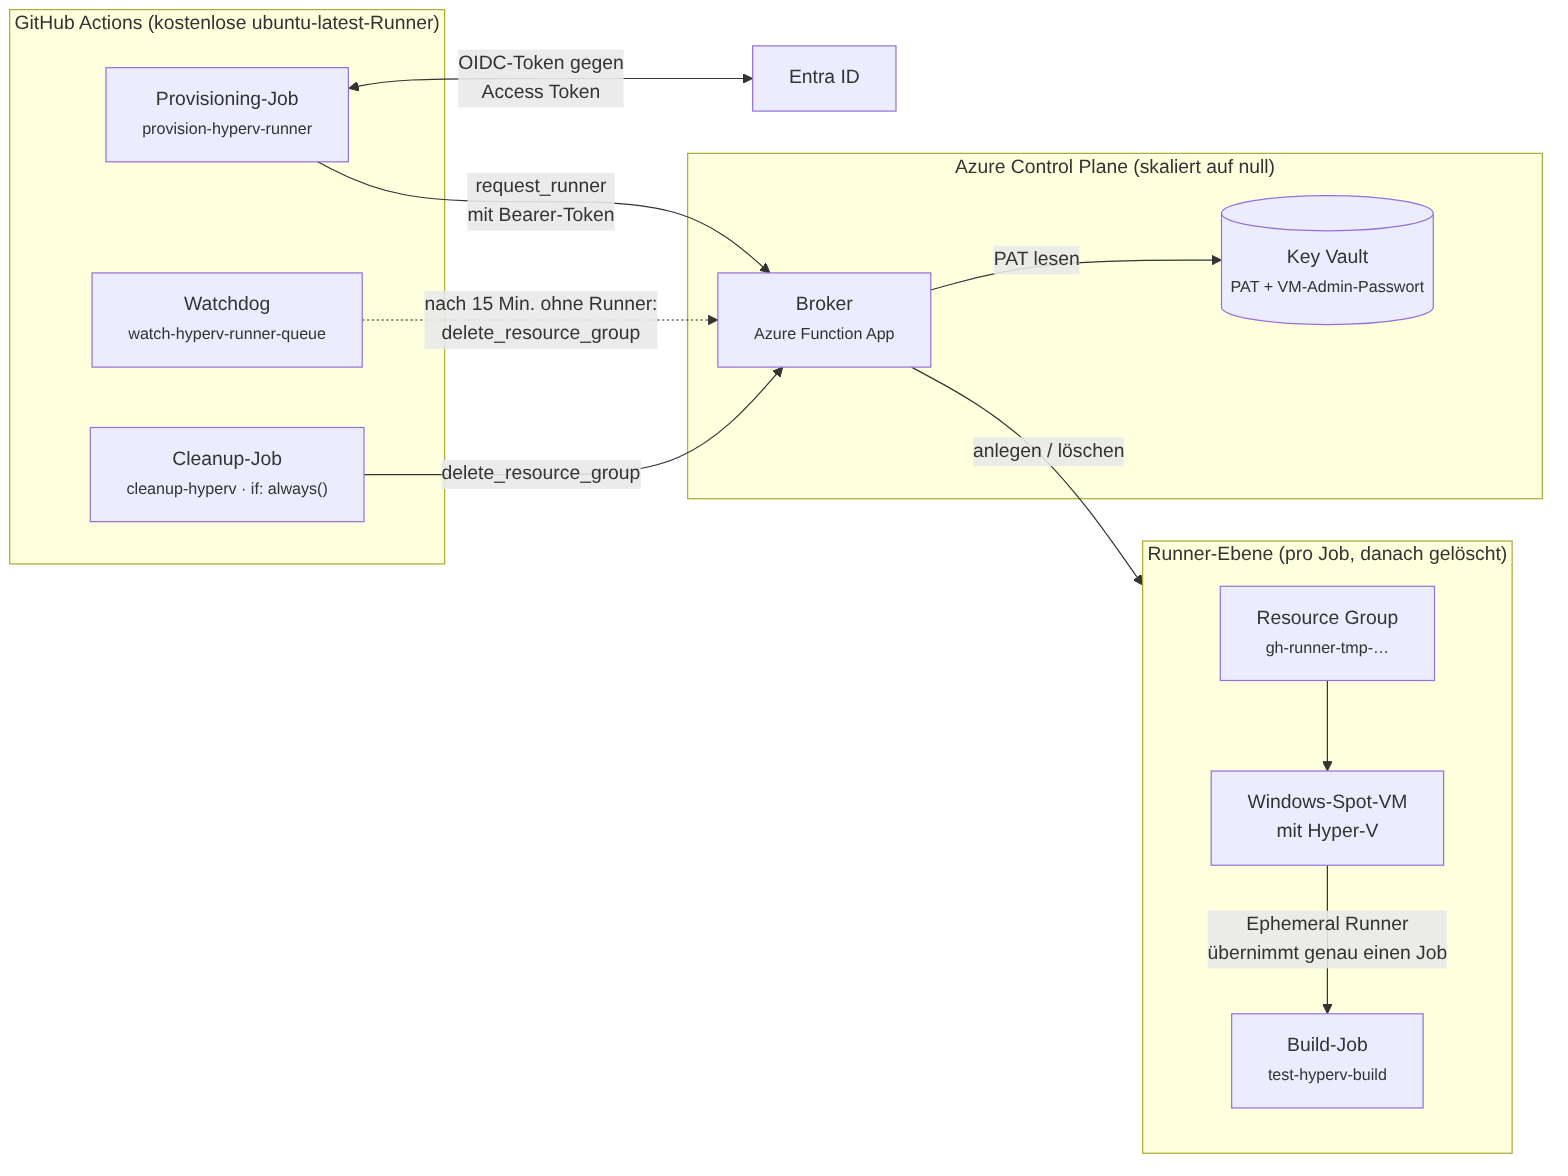
Die Plattform besteht aus zwei Teilen. Die Control Plane existiert dauerhaft und kostet wenig. Dazu gehören eine Azure Function App in Python auf dem Consumption Plan Y1 (abgerechnet wird pro Ausführung), ein Key Vault, ein Storage Account und Application Insights. Ich richte sie einmalig mit Terraform ein (manager.tf). In der Function App läuft der Broker mit genau zwei HTTP-Routen: request_runner holt ein Registration Token für den Runner und legt die VM an. delete_resource_group löscht alles wieder.
Die Runner-Ebene existiert nur für die Dauer eines Jobs. Für jede Anfrage legt der Broker über das Azure SDK eine eigene Resource Group an. Das ist eine Art Ordner für Azure-Ressourcen, der sich als Ganzes löschen lässt. Darin liegen VNet, NSG, NIC, öffentliche IP und schließlich die Spot-VM (function_app.py ab Zeile 230).
Golden Image. Damit die bezahlte VM nicht lange läuft, backe ich Runner-Agent und Toolchain vorab mit Packer in ein Image ein. Beim ersten Boot muss die VM dann nur noch Hyper-V einschalten und sich registrieren, statt alles zu installieren. Das Image ist per Sysprep generalisiert, also von allen maschinenspezifischen Daten befreit. Deshalb startet jeder Runner sauber (windows-azure-gh-runner.pkr.hcl).
Ein CI-Lauf von Anfang bis Ende
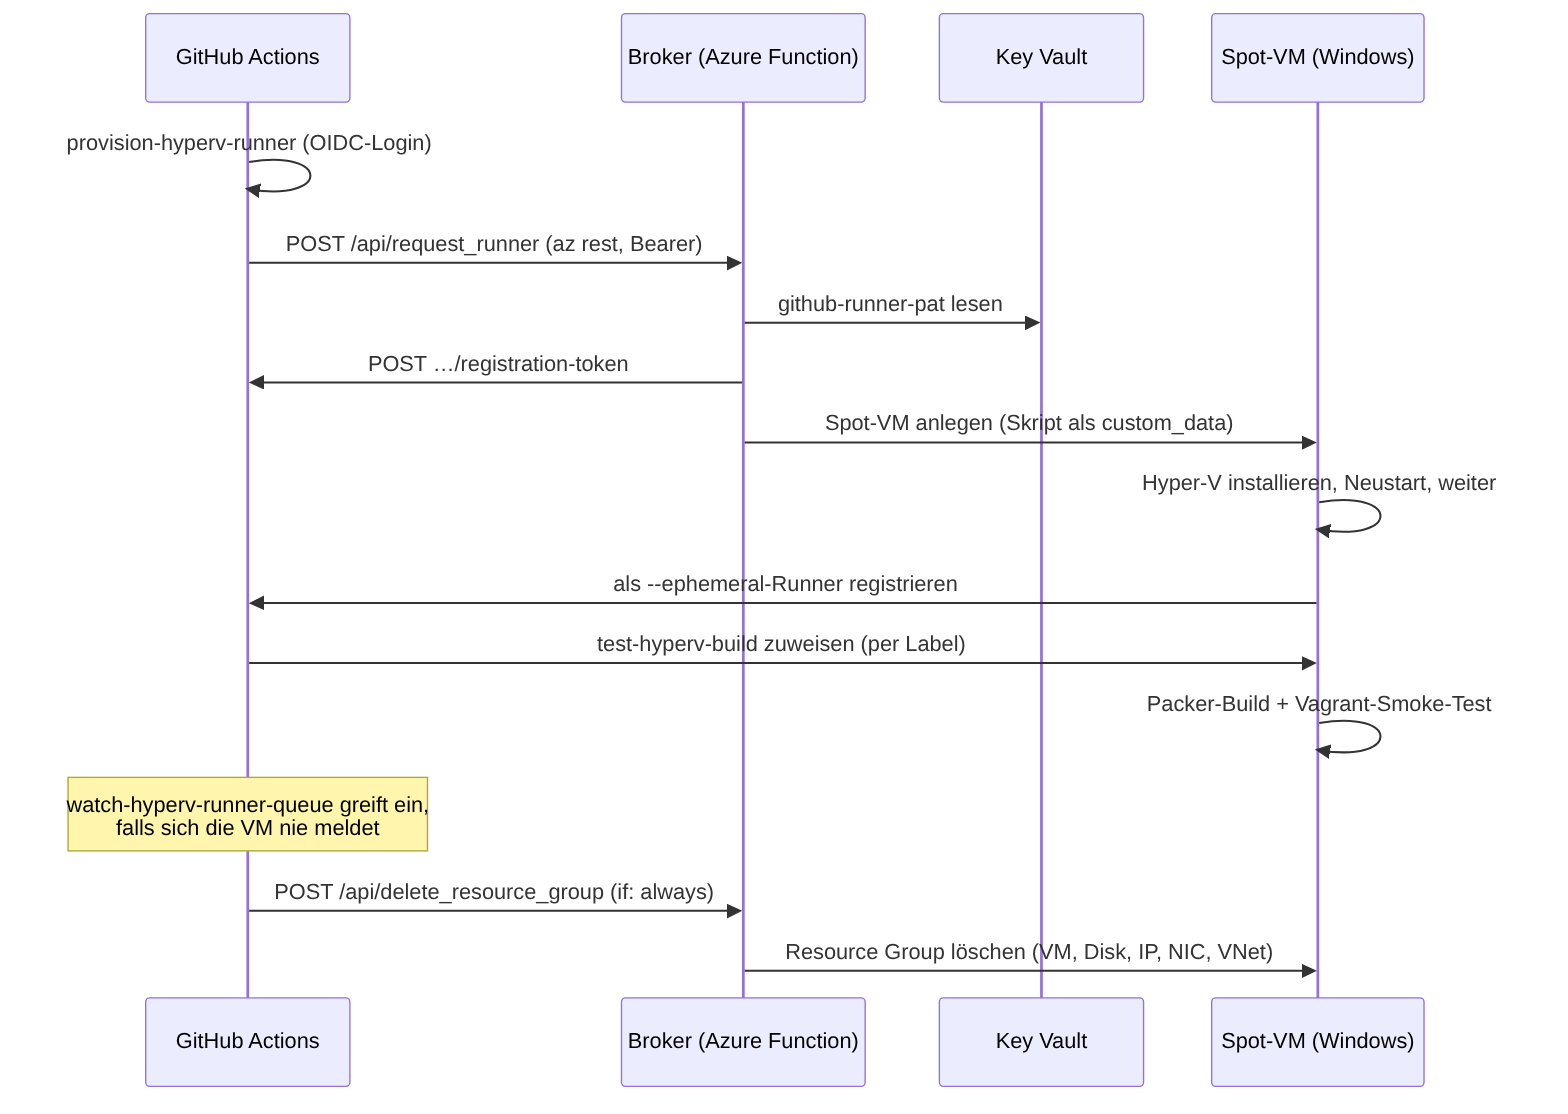
Der Workflow fordert die VM selbst beim Broker an, per az rest:
# .github/workflows/test-build-windows.yml
- name: Request Windows Runner VM
  run: |
    az rest \
      --method post \
      --uri "https://${{ secrets.FUNCTION_APP_NAME }}.azurewebsites.net/api/request_runner" \
      --resource "api://${{ secrets.AZURE_CLIENT_ID }}" \
      --body '{
        "repo": "${{ github.repository }}",
        "resource-group": "${{ steps.vars.outputs.resource-group }}",
        "runner-name": "${{ steps.vars.outputs.runner-name }}",
        "virtualization-flavor": "hyperv"
      }'
Quelle: test-build-windows.yml:58
Danach sorgen allein die Runner-Labels dafür, dass der Build-Job ausschließlich auf dieser frisch gestarteten VM läuft. Das letzte Label ist der Name des Runners, den der Provisioning-Job eigens für diesen Workflow-Lauf erzeugt hat. So kann sich ein Job nicht versehentlich die VM eines anderen Laufs schnappen. Gegen Absicht schützt das Label allein nicht, dazu mehr im Abschnitt zu Forks.
# .github/workflows/test-build-windows.yml
runs-on:
  - self-hosted
  - Windows
  - azure
  - nested
  - "${{ needs.provision-hyperv-runner.outputs.runner-name }}"
Quelle: test-build-windows.yml:121
Bis der Runner bereitsteht, vergehen in der Praxis 5 bis 8 Minuten. In dieser Zeit bootet die VM, aktiviert Hyper-V, startet neu und registriert sich. Der eigentliche Build dauert dann rund 40 Minuten.
Zwei Jobs sorgen dafür, dass danach keine VM übrig bleibt:
- Cleanup-Job. Er läuft mit
if: always(), also auch nach einem Fehler oder Abbruch, und ruftdelete_resource_groupauf. Damit verschwindet die ganze Resource Group mit VM, Disk, öffentlicher IP, NIC und VNet. - Watchdog. Er läuft parallel auf einem
ubuntu-latest-Runner und prüft alle 30 Sekunden, ob der Build-Job gestartet ist. Wartet der Job länger als 15 Minuten auf seinen Runner, löscht der Watchdog die Resource Group und bricht den Workflow-Lauf ab.
Hängt der Build selbst, greift nach 60 Minuten das Timeout des Jobs, und der Cleanup-Job räumt auf.
Das Golden Image baut sich selbst neu
Bisher habe ich das Golden Image per Skript von Hand gebaut. Dabei blieb etwas liegen: Renovate hebt die Version des GitHub-Actions-Runners im Repository automatisch an, aber ein neues Image hat daraus niemand gebaut. Dafür gibt es jetzt den Workflow build-azure-runner-image.yml. Er baut das Image neu:
- bei jedem Push auf
main, der das Packer-Template oder die Windows-Setup-Skripte ändert, also auch bei den Runner-Updates von Renovate - jeden Monat am 15., nach dem Patch Tuesday, damit Windows-Updates ins Image kommen
- auf Knopfdruck
Pull Requests prüfen das Template nur, sie bauen nie.
Dieser Workflow darf das Image ersetzen, mit dem jeder Runner startet. Deshalb ist er eng abgesichert:
- Eigene Identität. Er meldet sich mit einer eigenen Entra-App an,
gh-actions-image-builder. Ihre Federated Credential vertraut nur dem Branchmain, ein Pull Request kann das Image also nicht austauschen. - Rechte nur auf zwei Resource Groups. Die App ist
Contributorauf der Resource Group mit dem Image und auf einer eigenen für die temporären Build-Ressourcen von Packer. Rechte auf der ganzen Subscription hat sie nicht. - WinRM nur vom Runner aus. Die temporäre Build-VM nimmt WinRM-Verbindungen nur von der öffentlichen IP des Runners an.
- Tokens, die lange genug halten. Das Token der Azure CLI aus
azure/loginläuft nach etwa einer Stunde ab, ein Windows-Build kann aber länger dauern. Deshalb meldet sich Packer selbst per GitHub OIDC bei Azure an und holt sich bei Bedarf ein neues Token.
Einen Kompromiss nehme ich bewusst in Kauf: Der Workflow ersetzt das Managed Image direkt, ohne Versionen. Packer löscht das alte Image wegen -force gleich zu Beginn des Builds. Bis das neue fertig ist, schlagen Runner-Anfragen fehl. Das dauert rund 25 Minuten, im schlimmsten Fall bis zum Timeout des Jobs nach 150 Minuten. Scheitert der Build, gibt es gar kein Image mehr, bis ein neuer Build durchläuft. Eine Azure Compute Gallery mit versionierten Images würde beide Probleme lösen. Für dieses Projekt ist sie aber mehr Aufwand und mehr Kosten als nötig.
Seit dem 14. Oktober 2026 läuft der Workflow. Der erste Build nach dem Merge hat das Image in rund 25 Minuten neu gebaut, am 15. folgte der erste planmäßige Lauf.
Hyper-V auf einer Cloud-VM braucht mehr als einen Neustart
Das war der Teil, der am meisten Lehrgeld gekostet hat. Die erste Version hat Hyper-V nur eingeschaltet und neu gestartet. Für eine Demo von Hand reichte das, für eine verlässliche CI nicht. Die Hyper-V-Rolle verlangt einen Neustart, den der Runner überstehen muss. Und die Nested VMs brauchen ein eigenes Netz mit NAT und DHCP. „Hyper-V ist installiert“ ist eben etwas anderes als „eine Nested VM bootet und kommt ins Netz“.
Alles Nötige steckt in runner-setup.ps1. Der Broker übergibt das Skript base64-kodiert als custom_data an die VM.
1. Hyper-V-Rolle installieren. Server- und Client-Editionen von Windows brauchen dafür unterschiedliche Befehle. Deshalb prüft das Skript zuerst, auf welcher Edition es läuft (runner-setup.ps1:89).
2. Den Neustart überstehen. Das Skript legt den Scheduled Task ContinueRunnerSetup an, der beim Systemstart als SYSTEM läuft. Dann startet es die VM neu. Nach dem Neustart setzt der Task das Setup dort fort, wo es aufgehört hat (runner-setup.ps1:160).
3. Einen internen Switch für die Nested VMs anlegen. In diesem Netz bootet später die Windows-11-VM aus dem Packer-Build:
# runner-setup.ps1 (gekürzt)
# Create default virtual switch with NAT network (required for nested virtualization)
$existingSwitch = Get-VMSwitch -Name "Default Switch" -ErrorAction SilentlyContinue
if (-not $existingSwitch) {
    # ...
    New-VMSwitch -Name "Default Switch" -SwitchType Internal -ErrorAction Stop
    # ...
}
Quelle: runner-setup.ps1:184
4. Einen DHCP-Server nur für diesen Switch einrichten. Er ist an den Adapter des Default Switch gebunden und von allen anderen Adaptern getrennt. So vergibt er Adressen nur an die Nested VMs und kommt dem DHCP des Azure-VNets nicht in die Quere (runner-setup.ps1:241).
5. Dem Runner-Konto Rechte geben und es registrieren. Das Konto kommt in die lokalen Gruppen „Administrators“ und „Hyper-V Administrators“. Danach registriert es sich als Ephemeral Runner, also als Runner für genau einen Job:
Add-LocalGroupMember -Group "Administrators" -Member $RunnerUser -ErrorAction SilentlyContinue
Add-LocalGroupMember -Group "Hyper-V Administrators" -Member $RunnerUser -ErrorAction SilentlyContinue

.\config.cmd `
  --url $RepoUrl `
  --token $RunnerToken `
  --name $RunnerName `
  --labels windows,azure,nested,$RunnerName `
  --ephemeral `
  --unattended `
  --runasservice `
  --windowslogonaccount $RunnerUser `
  --windowslogonpassword $Password
Quelle: runner-setup.ps1:285
Keine Azure-Secrets in GitHub: OIDC, zwei Prüfungen, Isolation pro Job
Der Grundsatz: Keine Azure-Secrets in GitHub, und am Broker mehrere Schutzschichten hintereinander. Die wenigen langlebigen Secrets der Runner-Plattform liegen ausschließlich in Azure. Im Key Vault liegen ein GitHub Personal Access Token (PAT) und das Admin-Passwort der Runner-VMs. Der Access Key des Storage Accounts steht in den Einstellungen der Function App. Der Windows-Workflow nutzt in GitHub sonst nur die Zugangsdaten für den FTP-Server, auf dem die Builds große Dateien wie Windows-ISOs zwischenspeichern.
Workload Identity Federation zwischen GitHub und Entra ID
GitHub Actions meldet sich bei Azure mit einem kurzlebigen OIDC-Token an. Entra ID ist der Identitätsdienst von Azure, früher Azure AD. Es tauscht das OIDC-Token gegen ein Access Token (Workload Identity Federation).
Welche Workflows sich so anmelden dürfen, legen zwei Federated Credentials fest. Das sind Vertrauensregeln der Form „akzeptiere Tokens von GitHub für dieses Repository und diesen Branch“. Meine beiden Regeln erlauben die Anmeldung nur für den Branch main und für Pull Requests genau dieses Repositorys:
# deployments/terraform/modules/azure_gh_runner/github_oidc.tf (gekürzt)
resource "azuread_application_federated_identity_credential" "gh_actions_github_actions" {
  # ...
  issuer  = "https://token.actions.githubusercontent.com"
  subject = "repo:${var.github_repository}:ref:refs/heads/main"
}
# ...und eine zweite für :pull_request
Quelle: github_oidc.tf:46
Und Pull Requests aus Forks? Das Repository ist öffentlich. GitHub rät von Self-hosted Runnern in öffentlichen Repositorys ab, weil dort jeder per Pull Request Code auf den Runnern ausführen kann (GitHub-Doku).
Eine VM starten kann ein Fork trotzdem nicht. Der Workflow läuft mit pull_request, nicht mit pull_request_target. Für Pull Requests aus Forks gibt GitHub dann keine Secrets weiter (GitHub-Doku) und stuft alle Schreibrechte auf Lesen herab (GitHub-Doku). Für id-token gibt es keine Lesestufe, ein OIDC-Token bekommt der Lauf also nicht. Ohne OIDC-Token kommt der Provisioning-Job nicht am Broker vorbei.
Ein Restrisiko bleibt: Bei pull_request gilt die Workflow-Datei aus dem Pull Request. Ein Fork kann also einen Job direkt auf die Labels self-hosted, Windows, azure und nested schicken. Wartet in diesem Moment eine frische Runner-VM auf ihren Job, könnte sich der Job aus dem Fork diese VM schnappen. Dagegen hilft die Repository-Einstellung, Workflows aus Forks erst nach Freigabe laufen zu lassen. Ich habe sie auf „Require approval for all external contributors“ gesetzt (GitHub-Doku).
Auf Workflow-Ebene kommt als Berechtigung nur id-token: write hinzu. Der Watchdog-Job bekommt zusätzlich actions: write, damit er einen hängenden Lauf abbrechen kann. Der Login enthält nur IDs, keine Secrets:
permissions:
  contents: read
  id-token: write
# ...
- uses: azure/login@v3
  with:
    client-id:       ${{ secrets.AZURE_CLIENT_ID }}
    tenant-id:       ${{ secrets.AZURE_TENANT_ID }}
    subscription-id: ${{ secrets.AZURE_SUBSCRIPTION_ID }}
Die IDs liegen trotzdem unter secrets, damit GitHub sie in den Logs ausblendet. Geheim sind sie nicht: Ohne gültiges OIDC-Token aus diesem Repository kann niemand etwas mit ihnen anfangen.
Zwei Prüfungen am Broker
Der Broker ist doppelt abgesichert. Zuerst weist EasyAuth v2, die eingebaute Anmeldeprüfung von Azure App Service, anonyme Aufrufer ab, bevor überhaupt Code läuft (unauthenticated_action = "Return401"). Danach prüft der Code die Claims des Aufrufers, also die Angaben im Token, noch einmal selbst. Das geschieht auch dann, wenn EasyAuth schon zugestimmt hat. Tenant und Audience (für wen das Token ausgestellt wurde) müssen exakt stimmen. Außerdem muss die Client-ID oder die Object-ID des Aufrufers auf einer Allowlist stehen:
# scripts/gh-runner-func/function_app.py
if tenant_id != allowed_tenant:   return False, "tenant not allowed"
if audience != allowed_audience:  return False, "audience not allowed"
client_allowed = client_id in allowed_client_ids
user_allowed   = user_object_id in allowed_user_object_ids
if not client_allowed and not user_allowed:
    return False, "caller not allowlisted"
Quelle: function_app.py:88
Der Broker ist außerdem kein Empfänger für GitHubs workflow_job-Webhook. Der Workflow ruft ihn selbst auf, und das hat zwei Vorteile. Die Angriffsfläche beschränkt sich auf zwei authentifizierte Endpunkte statt eines öffentlichen Webhooks. Und die Provisionierung ist im Workflow-Graphen klar zu sehen.
Kurzlebige Registration Tokens
Den PAT aus dem Key Vault liest der Broker nur, um daraus ein Registration Token für den Runner zu erzeugen. Dieses Token gilt bei GitHub nur eine Stunde. Es landet ausschließlich auf der VM, und die wird nach dem Job samt Disk gelöscht (function_app.py:205).
Für Key Vault und Azure-Ressourcen nutzt die Function App eine System-assigned Managed Identity. Das ist eine Identität, die Azure dem Dienst selbst zuweist und für die kein Passwort gespeichert wird. Nur für ihren eigenen Storage Account steht noch der Access Key in den App-Settings.
Isolation pro Job und kleine Angriffsfläche
Jeder Job bekommt eine eigene Resource Group, und der Runner wird mit --ephemeral registriert: ein Job, danach meldet er sich ab. Beim Aufräumen verschwindet die ganze Gruppe. Der Broker löscht eine Resource Group aber nur, wenn sie zwei Bedingungen erfüllt. Erstens beginnt ihr Name mit gh-runner-tmp. Zweitens trägt sie das Tag managed-by: gh-runner-broker, das der Broker beim Anlegen setzt (function_app.py:406). So löscht er nicht versehentlich eine fremde Resource Group, die zufällig mit gh-runner-tmp beginnt. Gegen einen Aufrufer, der es darauf anlegt, schützt das noch nicht ganz (siehe die offenen Punkte unten).
Der Broker prüft außerdem die Eingaben des Aufrufers, bevor sie Azure oder GitHub erreichen: den Repository-Namen per Regex, die Virtualisierungsart gegen eine Allowlist (function_app.py:19).
Die NSG der Runner-VM, also ihre Firewall-Regeln, enthält keine einzige eingehende Regel. Eingehender Verkehr aus dem Internet trifft damit auf die Standardregel DenyAllInbound, und im VNet gibt es außer der Runner-VM nichts. Der Runner braucht nur ausgehende Verbindungen zu GitHub. Dafür hat er eine öffentliche IP.
Was vor dem Produktiveinsatz noch offen ist
In der ersten Version der Plattform habe ich bewusst einige Abkürzungen genommen. Manche davon sind inzwischen behoben, andere noch offen. Wer die Lösung übernimmt, sollte die offenen Punkte vor dem produktiven Einsatz schließen. Bei den meisten geht es darum, Rechte enger zu fassen.
Noch offen:
- Rolle des Brokers weiter eingrenzen. Die Managed Identity des Brokers hat eine Custom Role ohne Data-Plane-Rechte und ohne IAM. Die Rolle ist aber auf Subscription-Ebene zugewiesen und erlaubt
Microsoft.Compute/*undMicrosoft.Network/*. Über Compute-Aktionen wie Run Command oder den Export einer Disk kommt sie damit noch an die Inhalte aller VMs der Subscription heran. Enger ginge es mit einzelnen Aktionen oder mit einer eigenen Subscription nur für die Runner. - GitHub-Identität eingrenzen. Die App, mit der sich die Workflows per OIDC anmelden, hat noch
Contributorauf der Function App. Damit könnten Workflows aufmainund in Pull Requests Code und Einstellungen des Brokers ändern. Für den Aufruf des Brokers braucht die App das nicht. - Storage-Zugriff per Managed Identity. Die Function App greift auf ihren Storage Account noch mit dem Access Key zu. Mit
storage_uses_managed_identity = trueentfiele dieses gespeicherte Credential. - Runner-Konto ohne Admin-Rechte. Das Runner-Konto ist lokaler Administrator. Ob die Gruppe „Hyper-V Administrators“ allein reicht, wäre zu prüfen.
- Ein Passwort pro VM. Alle Runner-VMs bekommen dasselbe Admin-Passwort aus dem Key Vault.
- Zertifikat beim Image-Build prüfen. Packer spricht WinRM zwar über HTTPS (
winrm_use_ssl = true), prüft das Zertifikat wegenwinrm_insecure = trueaber nicht. Die Build-VM lebt nur kurz, und im neuen Build-Workflow ist WinRM nur noch von der IP des Runners aus erreichbar. Sauberer wäre trotzdem ein überprüfbares Zertifikat. - Vorhandene Resource Groups nicht übernehmen.
request_runnerlegt die Resource Group mitcreate_or_updatean und setzt dabei das Tagmanaged-by, auch wenn die Gruppe schon existiert. Ein Aufrufer auf der Allowlist könnte so eine fremde Resource Group mit dem Präfixgh-runner-tmperst markieren und dann löschen lassen.request_runnersollte bei einer vorhandenen Gruppe abbrechen. - Tag-Rechte knapp halten. Die Tag-Prüfung beim Löschen schützt nur, solange keine andere Identität das Tag
managed-byauf eine fremde Resource Group setzen kann.
Bereits erledigt:
- Kein RDP von außen. TCP 3389 ist nicht mehr aus dem Internet erreichbar. Für eine Debug-Sitzung ließe sich Azure Bastion (Zugang über das Azure-Portal) oder Just-in-Time-Zugriff (der Port öffnet sich nur kurz auf Anfrage) nutzen. Eingerichtet ist beides nicht, und beides kostet extra.
- Keine Contributor-Rolle mehr für den Broker. Statt
Contributorauf der ganzen Subscription hat seine Managed Identity die Custom Role von oben. - Purge Protection im Key Vault. Secrets lassen sich nicht endgültig löschen, bevor die Aufbewahrungsfrist abgelaufen ist.
- Eigentümer-Tag als zweite Löschbedingung zusätzlich zum Namenspräfix.
- Workflows aus Forks nur nach Freigabe. In den Actions-Einstellungen des Repositorys ist „Require approval for all external contributors“ gesetzt. Ein Pull Request aus einem Fork kann so keinen Job ungeprüft auf eine wartende Runner-VM schicken.
Die Rechnung: rund 2,50 € Fixkosten, rund 14 Cent pro Build
Für Oktober 2026 sagt Azure eine Rechnung von 2,92 € für die ganze Plattform voraus. Bis zum 14. Oktober waren es 1,30 €, bei einem vollständigen Build und einem abgebrochenen Lauf. Den größten Teil davon macht Speicher aus, nämlich 1,11 €. Auf die VMs entfallen nur 0,18 €. Hochgerechnet auf einen ganzen Monat kostet der Speicher rund 2,50 €, das sind die Fixkosten aus der Überschrift. Gemessen ist das vor den Korrekturen, die weiter unten beschrieben sind.
Die Compute-Kosten sind aus zwei Gründen so niedrig. Im Leerlauf läuft keine VM, und die Plattform stoppt die Runner-VM zwischen den Jobs nicht nur, sie löscht sie.
Die serverlose Control Plane skaliert auf null. Der Broker läuft auf dem Consumption Plan
Y1, abgerechnet wird pro Ausführung. Ohne CI-Lauf kostet er fast nichts.Compute fällt nur während eines Jobs an. Eine dauerhaft laufende VM existiert nicht. Der Cleanup-Job löscht nach jedem Lauf die ganze Resource Group. Zwischen zwei Läufen fallen also keine Kosten für Disk oder IP an. Das spart mehr, als die VM nur zu deallokieren.
Spot-VMs mit Fallback auf On-Demand-VMs. Spot senkt die VM-Kosten deutlich. Lehnt Azure die Spot-Anfrage direkt ab, fängt ein
try/exceptdas ab und legt eine On-Demand-VM an:Python# function_app.py (gekürzt) if use_spot: vm_params["priority"] = "Spot" vm_params["eviction_policy"] = "Deallocate" vm_params["billing_profile"] = {"max_price": -1} # höchstens der reguläre Preis try: compute.virtual_machines.begin_create_or_update(...) # erst Spot versuchen except Exception: # Spot-Einstellungen entfernen, als On-Demand-VM neu versuchen compute.virtual_machines.begin_create_or_update(...)Quelle: function_app.py:365
Dabei gibt es zwei Einschränkungen. Der Code wartet das Anlegen der Spot-VM nicht ab (
begin_create_or_updateohne.result()). Meldet Azure fehlende Kapazität erst später, greift der Fallback deshalb vermutlich nicht. Und holt Azure die Spot-VM mitten im Build zurück, bricht der Job ab und muss neu gestartet werden.Die Orchestrierung kostet nichts. Provisionieren, Watchdog und Aufräumen laufen auf den
ubuntu-latest-Runnern von GitHub, die für öffentliche Repositorys kostenlos sind. Nur der eigentliche Build läuft auf der bezahlten VM.
Wohin das Geld geht
Die Zahlen stammen aus der Kostenanalyse in Azure für den 1. bis 14. Oktober 2026:
| Komponente | Abrechnung | Kosten |
|---|---|---|
| Golden Images | zwei Managed Images (Hyper-V und VirtualBox) auf Premium SSD, dauerhaft gespeichert (ein Fehler, siehe unten) | 0,56 € |
| Terraform-State | Storage Account, dauerhaft (Ursache der Höhe noch offen, siehe unten) | 0,37 € |
| Build-Cache | Storage Account mit Blob-Cache, dauerhaft, nicht mehr genutzt (siehe unten) | 0,18 € |
| Function App, Key Vault, Netzwerk | Consumption Plan Y1 bzw. pro Zugriff | je unter 0,01 € |
| Runner-VMs | Standard_D4ds_v5 als Spot, nur solange sie existieren | 0,14 € für einen vollen Build, 0,04 € für einen abgebrochenen Lauf |
| Summe | 1,30 € |
Ein Build belegt die VM rund 50 Minuten: 5 bis 8 Minuten, bis der Runner bereitsteht, rund 40 Minuten Build und ein paar Minuten zum Aufräumen. Das kostet etwa 0,14 €. In aktiven Entwicklungsphasen liefen 30 bis 38 Builds im Monat. Hochgerechnet kämen dann rund 5 € für Compute zu den rund 2,50 € Speicher hinzu.
Was die Rechnung aufgedeckt hat
Erst beim Schreiben dieses Artikels habe ich mir die Speicherkosten genauer angesehen. Dabei sind drei Fehler aufgefallen:
- Premium SSD für das Golden Image. Packer legte das Image auf Premium SSD ab (
managed_image_storage_account_type = "Premium_LRS"in windows-azure-gh-runner.pkr.hcl). Gespeicherte Images werden wie Snapshots nach belegtem Speicher abgerechnet. In East US 2 kostet das auf Premium SSD 0,1056 € pro GB und Monat, auf Standard HDD 0,044 € (Azure-Preise für Managed Disks). Für ein Image, das nur beim Anlegen einer VM gelesen wird, reicht Standard völlig. Inzwischen steht im CodeStandard_LRS, und seit dem Image-Build vom 14. Oktober liegt das Image auf Standard HDD. Die Runner-VMs betrifft diese Änderung nicht, denn den Typ ihrer OS-Disk legt der Broker getrennt fest. - Zwei Images statt einem. Das Build-Skript baute zwei Images, eines für Hyper-V und eines für VirtualBox, beide auf Premium SSD. Das VirtualBox-Image wurde gar nicht genutzt, denn die VirtualBox-Jobs in
test-build-windows.ymlsind derzeit deaktiviert. Jetzt baut das Skript standardmäßig nur noch das Hyper-V-Image. Das alte VirtualBox-Image habe ich von Hand gelöscht. - Ein vergessener Build-Cache. Der Storage Account in der Resource Group
gh-runner-storage-rgist ein Blob-Cache für Builds, zum Beispiel für Windows-ISOs. Alle Workflows nutzen inzwischen einen FTP-Cache, bezahlt wurde der gespeicherte Inhalt trotzdem. Im Terraform-Code ist der Cache jetzt abgeschaltet (build_cache_enabled = false). Der letzteterragrunt applyhat den Storage Account samt Inhalt gelöscht.
Seit dem 14. Oktober sind alle drei Korrekturen ausgerollt, die Zahlen oben stammen noch von davor. Wie viel sie zusammen sparen, kann ich deshalb noch nicht sagen. Allein für die Speicherart habe ich überschlagen: Auf Standard HDD würden die beiden Images statt rund 1,20 € nur rund 0,50 € im Monat kosten. Damit läge die Oktober-Rechnung bei gut 2 € statt knapp 3 €. In dieser Schätzung fehlt noch, dass das VirtualBox-Image ganz wegfällt und der Build-Cache gelöscht wird. Die echte Ersparnis zeigt die Kostenanalyse der nächsten Wochen.
Noch offen ist, warum der Storage Account für den Terraform-State für ein paar Kilobyte State 0,37 € kostet. An der Terraform-Konfiguration liegt es nicht: Der Account hat Standard-Tier und LRS, Blob-Versionierung und Soft Delete sind aus. Die Ursache muss also außerhalb von Terraform liegen. Möglich sind Einstellungen, die im Portal geändert wurden, oder Transaktionskosten, weil jeder plan und jedes apply den State liest, schreibt und sperrt. Klären soll das als Nächstes die Kostenanalyse, aufgeschlüsselt nach einzelnen Abrechnungsposten.
Ebenfalls geprüft und bewusst nicht geändert: Die OS-Disk der Runner-VMs bleibt auf Premium SSD. Sie existiert nur, solange ein Job läuft, kostet also wenig, und der Build profitiert vom schnellen I/O. Eine Ephemeral OS Disk habe ich verworfen. Bei Standard_D4ds_v5 würde die rund 127 GB große OS-Disk den größten Teil der 150 GB großen Temp-Disk belegen, und der Build schreibt seine temporären Packer-Dateien auf genau diese Disk (D:).
Fazit
Das Ergebnis für Sailwright: Jeder Windows-Build läuft auf einer frischen Hyper-V-VM. Im Leerlauf kostet die Plattform rund 2,50 € im Monat, fast alles davon für Speicher. Dazu kommen rund 14 Cent pro Build. Die drei Fehler bei den Speicherkosten sind behoben und ausgerollt. Wie viel ihre Korrektur spart, zeigt die nächste Kostenanalyse.
Der Ansatz taugt für mehr: Ein serverloser Broker, OIDC und kurzlebige Spot-VMs passen zu vielen CI-Jobs, die viel Rechenleistung oder spezielle Hardware brauchen, aber selten laufen. Beispiele sind GPU-Jobs, große Integrationstests oder, wie hier, Nested Virtualization. Ein solcher Broker bringt drei Vorteile: Im Leerlauf fallen fast keine Compute-Kosten an, in GitHub liegen keine Azure-Secrets, und jeder Job ist sauber isoliert. Der Preis sind 5 bis 8 Minuten Wartezeit, bis die VM bereitsteht, und ein Broker, der gepflegt werden will.
Nicht geeignet ist der Ansatz, wenn Jobs schnell starten müssen, denn jeder Lauf wartet erst auf seine VM. Teurer wird es in privaten Repositories: Dort rechnet GitHub auch die Orchestrierungs-Jobs auf den GitHub-hosted Runnern nach Minuten ab. Außerdem ist Spot-Kapazität nicht garantiert, gerade bei GPU-VMs.
Der komplette Code ist Open Source: github.com/csautter/sailwright.
 German
 English